升级 Strata 主机,应一起看模型耗时、实际添加支出与内存容量。本文以 i7-11700、RTX 5060 Ti 16GB、64GB DDR4-3200 双信道为基准,分开呈现原版 IQ3_XXS 的条件式预测与Swift 1.5 IQ2_XS 的实测及历史成本。
Strata 系列:模型比较与实测 · 硬件公式与验证 · 升级成本与效益
数据整理于 2026 年 10 月。价格是先前查得的估值与套餐价格,不是目前现货报价;预测也不等于换机后的保证收益。
原版 IQ3_XXS:硬件升级可望省多少时间?
v4 公式固定使用 Strata 0.1.41 九次测试中位数:Prefill 1,666.44、Decode 51.30 tokens/s。以 51,200 输入+4,096 输出换算,基准为 110.568233 秒。后续 0.1.43.1 实测没有替换这个校准基准。
下表为尚未逐项换硬件验证的点估计。「省时百分比」正值表示更快,负值表示更慢;小数字供计算核对,不代表相同程度的预测精度。
| 变更情境 | 显卡链路 | Prefill tokens/s | Decode tokens/s | 换算秒数 | 省时百分比 |
|---|---|---|---|---|---|
| 本机基准 | 4.0 x8 | 1,666.44 | 51.30 | 110.57 | 0.00% |
| PCIe 5+5060 Ti | 5.0 x8 | 1,823.85 | 56.55 | 100.51 | 9.10% |
| DDR5-5600+5060 Ti | 4.0 x8 | 1,666.44 | 56.95 | 102.64 | 7.17% |
| RAM 128GB+5060 Ti | 4.0 x8 | 1,666.44 | 51.30 | 110.57 | 0.00% |
| RTX 3060 12GB | 4.0 x16 | 1,046.38 | 39.21 | 153.38 | −38.72% |
| RTX 5070 12GB | 4.0 x16 | 1,602.74 | 51.98 | 110.75 | −0.16% |
| RTX 5070 Ti 16GB | 4.0 x16 | 2,580.38 | 73.07 | 75.90 | 31.36% |
| RTX 5080 16GB | 4.0 x16 | 2,723.52 | 75.60 | 72.98 | 34.00% |
| PCIe 5+DDR5+5060 Ti | 5.0 x8 | 1,823.85 | 62.78 | 93.32 | 15.60% |
| PCIe 5+DDR5+5070 | 5.0 x16 | 1,725.76 | 62.50 | 95.20 | 13.90% |
| PCIe 5+DDR5+5070 Ti | 5.0 x16 | 2,778.43 | 87.86 | 65.04 | 41.17% |
| PCIe 5+DDR5+5080 | 5.0 x16 | 2,932.56 | 90.91 | 62.51 | 43.46% |
主要条件:DDR5 指双信道 5600 MT/s、理论带宽 89.6 GB/s;CPU 能力统一固定为 i7-11700 的 20,585 分,以隔离其他变量。实际换 DDR5/PCIe 5 平台必须更换 CPU,应另代入新 CPU 分数。H2D 传输速度设置为 Gen4 ×8=13.8、Gen4 ×16=27.6、Gen5 ×8=28.5、Gen5 ×16=50 GB/s,只有 13.8 GB/s 是本机实测。
RTX 5070 单换卡的 −0.16% 应读作大致持平。128GB 的 0% 则假设原本没有内存压力、热工作集已驻内存,且频率、信道与数据放置不变;增加容量仍有助于容纳更大模型及更多应用程序。
v4 跨主机合成耗时的平均绝对百分比误差(MAPE)为 10.88%。这是验证集的平均误差,不能当成每个方案的误差范围。尤其数个百分点的差异,不宜据此断言某方案一定较快。
Swift IQ2_XS:历史成本、CPU 跑分与实测耗时
以下改用 Swift 1.5 IQ2_XS,不能与前表原版 IQ3_XXS 直接串接。本机是 Strata 0.1.41、2026 年 10 月 11 日九次中位数;作者是 Strata 0.1.26、每格单次测试。i5/i7 升级后的 Swift 速度尚未实测,表中的「待实测」不代表零提升。
| 项目 | 本机 Swift 基准 | 升级 i5 | 升级 i7 | 作者 |
|---|---|---|---|---|
| 比较用金额(非统一新购价) | NT$69,656 | NT$81,446 | NT$86,846 | NT$85,118 |
| 较基准增加的比较金额 | 基准 | +NT$11,790 | +NT$17,190 | +NT$15,462(估值差) |
| 比较用金额变化 | 基准 | +16.9% | +24.7% | +22.2% |
| CPU | i7-11700 | i5-14400F | i7-14700F | Ryzen 5 7600 |
| 内核/线程 | 8 核/16 绪 | 10 核/16 绪 | 20 核/28 绪 | 6 核/12 绪 |
| PassMark 单线程平均跑分提升 | 基准 | +13.7% | +30.7% | +20.0% |
| PassMark 多线程平均跑分提升 | 基准 | +23.5% | +100.5% | +31.0% |
| 主板 | PRIME B560M-K | TUF B760M-PLUS WIFI D4 | TUF B760M-PLUS WIFI D4 | 未公开,价格采同级估算 |
| GPU | RTX 5060 Ti 16GB | 沿用 | 沿用 | RTX 5070 12GB |
| 内存 | 64GB DDR4-3200 双信道 | 沿用 | 沿用 | 64GB DDR5-5200(信道未确认) |
| RAM 理论峰值带宽 | 51.2 GB/s | 51.2 GB/s | 51.2 GB/s | 83.2 GB/s(假设双信道) |
| 显卡 PCIe | 4.0 ×8 | 5.0 ×8 | 5.0 ×8 | 5.0 ×16 |
| PCIe 单向理论带宽 | 15.8 GB/s | 31.5 GB/s | 31.5 GB/s | 63.0 GB/s |
| Prefill(32K 档位) | 1,622.10 tokens/s | 待实测 | 待实测 | 2,092.02 tokens/s |
| Prefill 速度提升 | 基准 | 待实测 | 待实测 | +29.0% |
| Decode(4K 档位) | 65.55 tokens/s | 待实测 | 待实测 | 78.60 tokens/s |
| Decode 速度提升 | 基准 | 待实测 | 待实测 | +19.9% |
| 需 Prefill 的 51,200 tokens 处理时间(粗估) | 31.6 秒 | 待实测 | 待实测 | 24.5 秒 |
| 输入处理时间变化 | 0% | 待实测 | 待实测 | −22.5% |
| 情境输出 4,096 tokens 的模型生成时间(粗估) | 62.5 秒 | 待实测 | 待实测 | 52.1 秒 |
| 回答生成时间变化 | 0% | 待实测 | 待实测 | −16.6% |
| LLM 输入+输出合计时间(粗估) | 94.1 秒 | 待实测 | 待实测 | 76.6 秒 |
| LLM 合计时间变化(图表采用) | 0% | 待实测 | 待实测 | −18.6% |
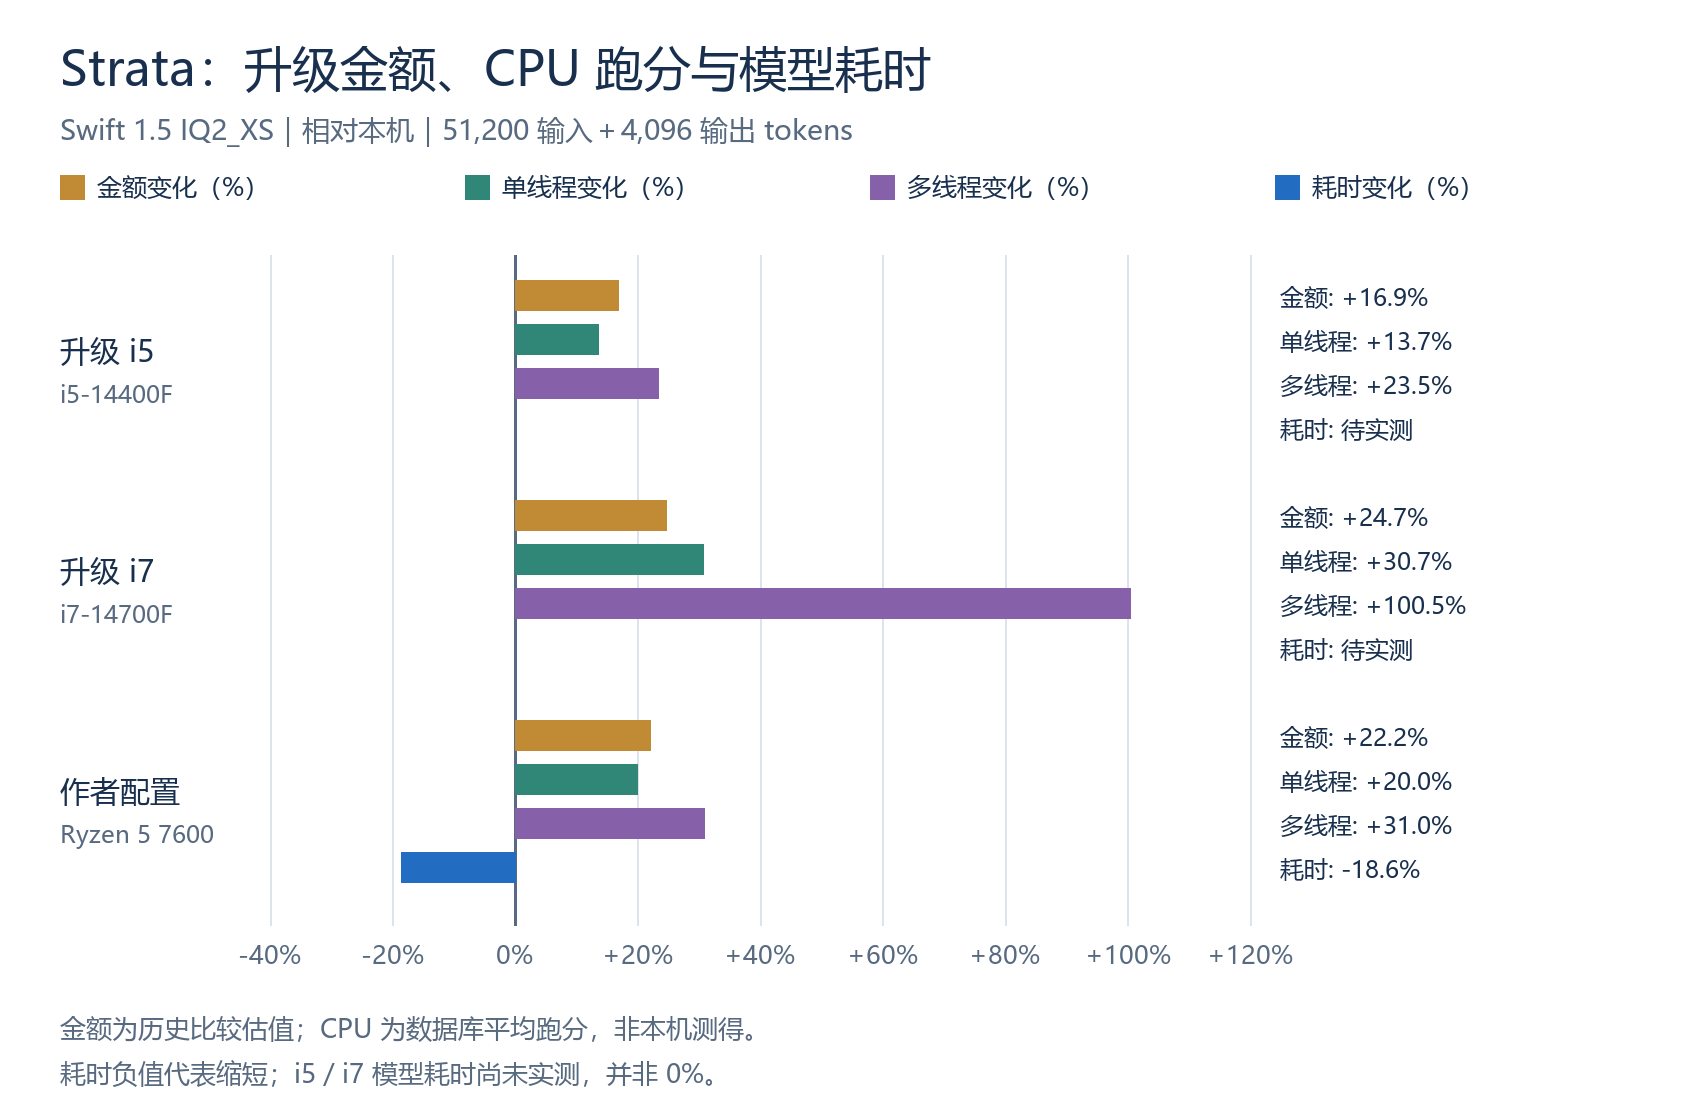
成本口径:保留一颗 2TB M.2 SSD、不含 HDD。i5/i7 套餐历史支出为 NT$11,790/NT$17,190,直接叠加在原配置全新重估 NT$69,656 上;未扣除旧 CPU、主板的估值或转售收入。作者 NT$85,118 是含替代零件的同级整机估值,不是实际购入价。因此四栏并非相同口径的新购整机价格。
CPU 增幅来自 PassMark 数据库样本平均,并非四台电脑各自的实测,也不代表 Strata 同幅加速。作者的 DDR5-5200 信道配置未确认,83.2 GB/s 只是假设双信道的理论值。双方模型虽同标 Swift 1.5 IQ2_XS,引擎版本、MTP 词汇表及提示文本仍不同,作者亦未记录模型文件 SHA。名义 32K/4K 档位的实际 prompt 为 31,566/3,562 tokens。
早期原版 IQ2_XS 曾估 i5 约 2,000/73、i7 约 2,000/77 tokens/s(Prefill/Decode),这些历史估算不适用于 Swift,因此没有填入表格。
为何采 51,200 输入+4,096 输出?
TraceLab 公开研究的 23.4 亿未命中缓存输入与 1.869 亿输出,整体比例约 12.52:1。此处取 12.5:1,沿用 4,096 输出作比较尺度,得到 51,200 输入。输入排除命中缓存部分、包含缓存失效后重算;输出包含思考、工具调用、代码和回答。
这是按整体比例标准化的情境,不是每轮或每个 coding-agent 任务的平均。研究使用 Claude/Codex,并非本机 Qwen;累计输入亦不是单轮上下文长度。
合成耗时 T = 51,200 ÷ Prefill + 4,096 ÷ Decode
省时百分比 = (1 − T ÷ 基准耗时) × 100%
耗时变化率 = (T ÷ 基准耗时 − 1) × 100%
两种百分比正负号相反:第一张表采「省时」,Swift 表与下方示例采「耗时变化」。计算使用未四舍五入的值,显示秒数相加可能差 0.1 秒。
上述秒数沿用 32K Prefill、4K Decode 的固定速度,没有逐轮配合上下文长度调整,也不包含工具运行、编译、测试、网络、调度及额外摘要。因此它是模型固定工作量比较,不是完整 coding-agent 任务耗时。更精确的估算需逐轮、同上下文长度测速。
历史带宽示例:假设等待占比 24.1% 时会如何?
以下只示范 Amdahl 定律,不是 v4 预测,也不是升级实测。基准改回 Swift IQ2_XS 的 94.1 秒。
| 配置 | 等待占比假设 | 模型总耗时 | 减少秒数 | 耗时变化 |
|---|---|---|---|---|
| 目前:PCIe 4.0 ×8+DDR4-3200 双信道 | 基准 | 94.1 秒 | — | — |
| PCIe 5.0 ×8+DDR4-3200 双信道 | PCIe 等待 24.1% | 82.7 秒 | 11.3 秒 | −12.1% |
| PCIe 4.0 ×8+DDR5-5200 双信道 | DDR 等待 24.1%(额外假设) | 85.3 秒 | 8.7 秒 | −9.3% |
| PCIe 4.0 ×8+DDR5-6000 双信道 | DDR 等待 24.1%(额外假设) | 83.5 秒 | 10.6 秒 | −11.2% |
| PCIe 5.0 ×8+DDR5-5200 双信道 | PCIe 与 DDR 各 24.1%,合计 48.2%(互不重叠假设) | 74.0 秒 | 20.1 秒 | −21.3% |
| PCIe 5.0 ×8+DDR5-6000 双信道 | PCIe 与 DDR 各 24.1%,合计 48.2%(互不重叠假设) | 72.1 秒 | 21.9 秒 | −23.3% |
24.1% 来自 DALI 的 PCIe 传输占比。试算额外假设它都是可随带宽改善、且未被其他运算重叠的等待;DDR 使用同一比例没有研究或本机测量支持。合并方案再假设两者各占 24.1%、互不重叠,合计 48.2%;若实际重叠,会高估收益。
单项:T新 = T原 × (1 − 0.241 + 0.241 ÷ 带宽倍率)
合并:T新 = T原 × (1 − 0.241 − 0.241 + 0.241 ÷ 2 + 0.241 ÷ DDR倍率)
PCIe、DDR5-5200、DDR5-6000 的倍率分别为 2、1.625、1.875,假设有效带宽依理论值等比例增加;不包含 CPU 更换效应。各列独立对照基准,不能把这组结果当成前表的额外加速量。
怎么判断升级是否划算?
先确认现有 RAM 是否不足,再以实际添加支出、使用频率和节省时间评估。i5/i7 套餐尚缺 Swift 实测,无法仅凭 CPU 跑分判断;单换 RTX 5070 的 v4 结果接近持平,也不足以构成升级理由。高端 GPU 的预估省时较大,但仍应把这些条件式结果当成测试方向,而非购买承诺。
数据源
- Strata 作者的 0.1.26 速度测试、原始测速数据及技术说明。
- PassMark:i7-11700、i5-14400F、i7-14700F、Ryzen 5 7600。2026 年 10 月 11 日记录的单/多线程分数依序为 3,255/20,583、3,700/25,413、4,254/41,262、3,907/26,959;与 v4 固定基准 20,585 分属不同数据截点。
- 历史套餐来源:PChome i5-14400F 套餐、i7-14700F 套餐。本文不宣称目前仍有相同价格或库存。


留言讨论