升級 Strata 主機,應一起看模型耗時、實際新增支出與記憶體容量。本文以 i7-11700、RTX 5060 Ti 16GB、64GB DDR4-3200 雙通道為基準,分開呈現原版 IQ3_XXS 的條件式預測與Swift 1.5 IQ2_XS 的實測及歷史成本。
Strata 系列:模型比較與實測 · 硬體公式與驗證 · 升級成本與效益
資料整理於 2026 年 10 月。價格是先前查得的估值與套餐價格,不是目前現貨報價;預測也不等於換機後的保證收益。
原版 IQ3_XXS:硬體升級可望省多少時間?
v4 公式固定使用 Strata 0.1.41 九次測試中位數:Prefill 1,666.44、Decode 51.30 tokens/s。以 51,200 輸入+4,096 輸出換算,基準為 110.568233 秒。後續 0.1.43.1 實測沒有替換這個校準基準。
下表為尚未逐項換硬體驗證的點估計。「省時百分比」正值表示更快,負值表示更慢;小數位供計算核對,不代表相同程度的預測精度。
| 變更情境 | 顯卡鏈路 | Prefill tokens/s | Decode tokens/s | 換算秒數 | 省時百分比 |
|---|---|---|---|---|---|
| 本機基準 | 4.0 x8 | 1,666.44 | 51.30 | 110.57 | 0.00% |
| PCIe 5+5060 Ti | 5.0 x8 | 1,823.85 | 56.55 | 100.51 | 9.10% |
| DDR5-5600+5060 Ti | 4.0 x8 | 1,666.44 | 56.95 | 102.64 | 7.17% |
| RAM 128GB+5060 Ti | 4.0 x8 | 1,666.44 | 51.30 | 110.57 | 0.00% |
| RTX 3060 12GB | 4.0 x16 | 1,046.38 | 39.21 | 153.38 | −38.72% |
| RTX 5070 12GB | 4.0 x16 | 1,602.74 | 51.98 | 110.75 | −0.16% |
| RTX 5070 Ti 16GB | 4.0 x16 | 2,580.38 | 73.07 | 75.90 | 31.36% |
| RTX 5080 16GB | 4.0 x16 | 2,723.52 | 75.60 | 72.98 | 34.00% |
| PCIe 5+DDR5+5060 Ti | 5.0 x8 | 1,823.85 | 62.78 | 93.32 | 15.60% |
| PCIe 5+DDR5+5070 | 5.0 x16 | 1,725.76 | 62.50 | 95.20 | 13.90% |
| PCIe 5+DDR5+5070 Ti | 5.0 x16 | 2,778.43 | 87.86 | 65.04 | 41.17% |
| PCIe 5+DDR5+5080 | 5.0 x16 | 2,932.56 | 90.91 | 62.51 | 43.46% |
主要條件:DDR5 指雙通道 5600 MT/s、理論頻寬 89.6 GB/s;CPU 能力統一固定為 i7-11700 的 20,585 分,以隔離其他變數。實際換 DDR5/PCIe 5 平台必須更換 CPU,應另代入新 CPU 分數。H2D 傳輸速度設定為 Gen4 ×8=13.8、Gen4 ×16=27.6、Gen5 ×8=28.5、Gen5 ×16=50 GB/s,只有 13.8 GB/s 是本機實測。
RTX 5070 單換卡的 −0.16% 應讀作大致持平。128GB 的 0% 則假設原本沒有記憶體壓力、熱工作集已駐記憶體,且頻率、通道與資料放置不變;增加容量仍有助於容納更大模型及更多應用程式。
v4 跨主機合成耗時的平均絕對百分比誤差(MAPE)為 10.88%。這是驗證集的平均誤差,不能當成每個方案的誤差範圍。尤其數個百分點的差異,不宜據此斷言某方案一定較快。
Swift IQ2_XS:歷史成本、CPU 跑分與實測耗時
以下改用 Swift 1.5 IQ2_XS,不能與前表原版 IQ3_XXS 直接串接。本機是 Strata 0.1.41、2026 年 10 月 11 日九次中位數;作者是 Strata 0.1.26、每格單次測試。i5/i7 升級後的 Swift 速度尚未實測,表中的「待實測」不代表零提升。
| 項目 | 本機 Swift 基準 | 升級 i5 | 升級 i7 | 作者 |
|---|---|---|---|---|
| 比較用金額(非統一新購價) | NT$69,656 | NT$81,446 | NT$86,846 | NT$85,118 |
| 較基準增加的比較金額 | 基準 | +NT$11,790 | +NT$17,190 | +NT$15,462(估值差) |
| 比較用金額變化 | 基準 | +16.9% | +24.7% | +22.2% |
| CPU | i7-11700 | i5-14400F | i7-14700F | Ryzen 5 7600 |
| 核心/執行緒 | 8 核/16 緒 | 10 核/16 緒 | 20 核/28 緒 | 6 核/12 緒 |
| PassMark 單執行緒平均跑分提升 | 基準 | +13.7% | +30.7% | +20.0% |
| PassMark 多執行緒平均跑分提升 | 基準 | +23.5% | +100.5% | +31.0% |
| 主機板 | PRIME B560M-K | TUF B760M-PLUS WIFI D4 | TUF B760M-PLUS WIFI D4 | 未公開,價格採同級估算 |
| GPU | RTX 5060 Ti 16GB | 沿用 | 沿用 | RTX 5070 12GB |
| 記憶體 | 64GB DDR4-3200 雙通道 | 沿用 | 沿用 | 64GB DDR5-5200(通道未確認) |
| RAM 理論峰值頻寬 | 51.2 GB/s | 51.2 GB/s | 51.2 GB/s | 83.2 GB/s(假設雙通道) |
| 顯卡 PCIe | 4.0 ×8 | 5.0 ×8 | 5.0 ×8 | 5.0 ×16 |
| PCIe 單向理論頻寬 | 15.8 GB/s | 31.5 GB/s | 31.5 GB/s | 63.0 GB/s |
| Prefill(32K 檔位) | 1,622.10 tokens/s | 待實測 | 待實測 | 2,092.02 tokens/s |
| Prefill 速度提升 | 基準 | 待實測 | 待實測 | +29.0% |
| Decode(4K 檔位) | 65.55 tokens/s | 待實測 | 待實測 | 78.60 tokens/s |
| Decode 速度提升 | 基準 | 待實測 | 待實測 | +19.9% |
| 需 Prefill 的 51,200 tokens 處理時間(粗估) | 31.6 秒 | 待實測 | 待實測 | 24.5 秒 |
| 輸入處理時間變化 | 0% | 待實測 | 待實測 | −22.5% |
| 情境輸出 4,096 tokens 的模型生成時間(粗估) | 62.5 秒 | 待實測 | 待實測 | 52.1 秒 |
| 回答生成時間變化 | 0% | 待實測 | 待實測 | −16.6% |
| LLM 輸入+輸出合計時間(粗估) | 94.1 秒 | 待實測 | 待實測 | 76.6 秒 |
| LLM 合計時間變化(圖表採用) | 0% | 待實測 | 待實測 | −18.6% |
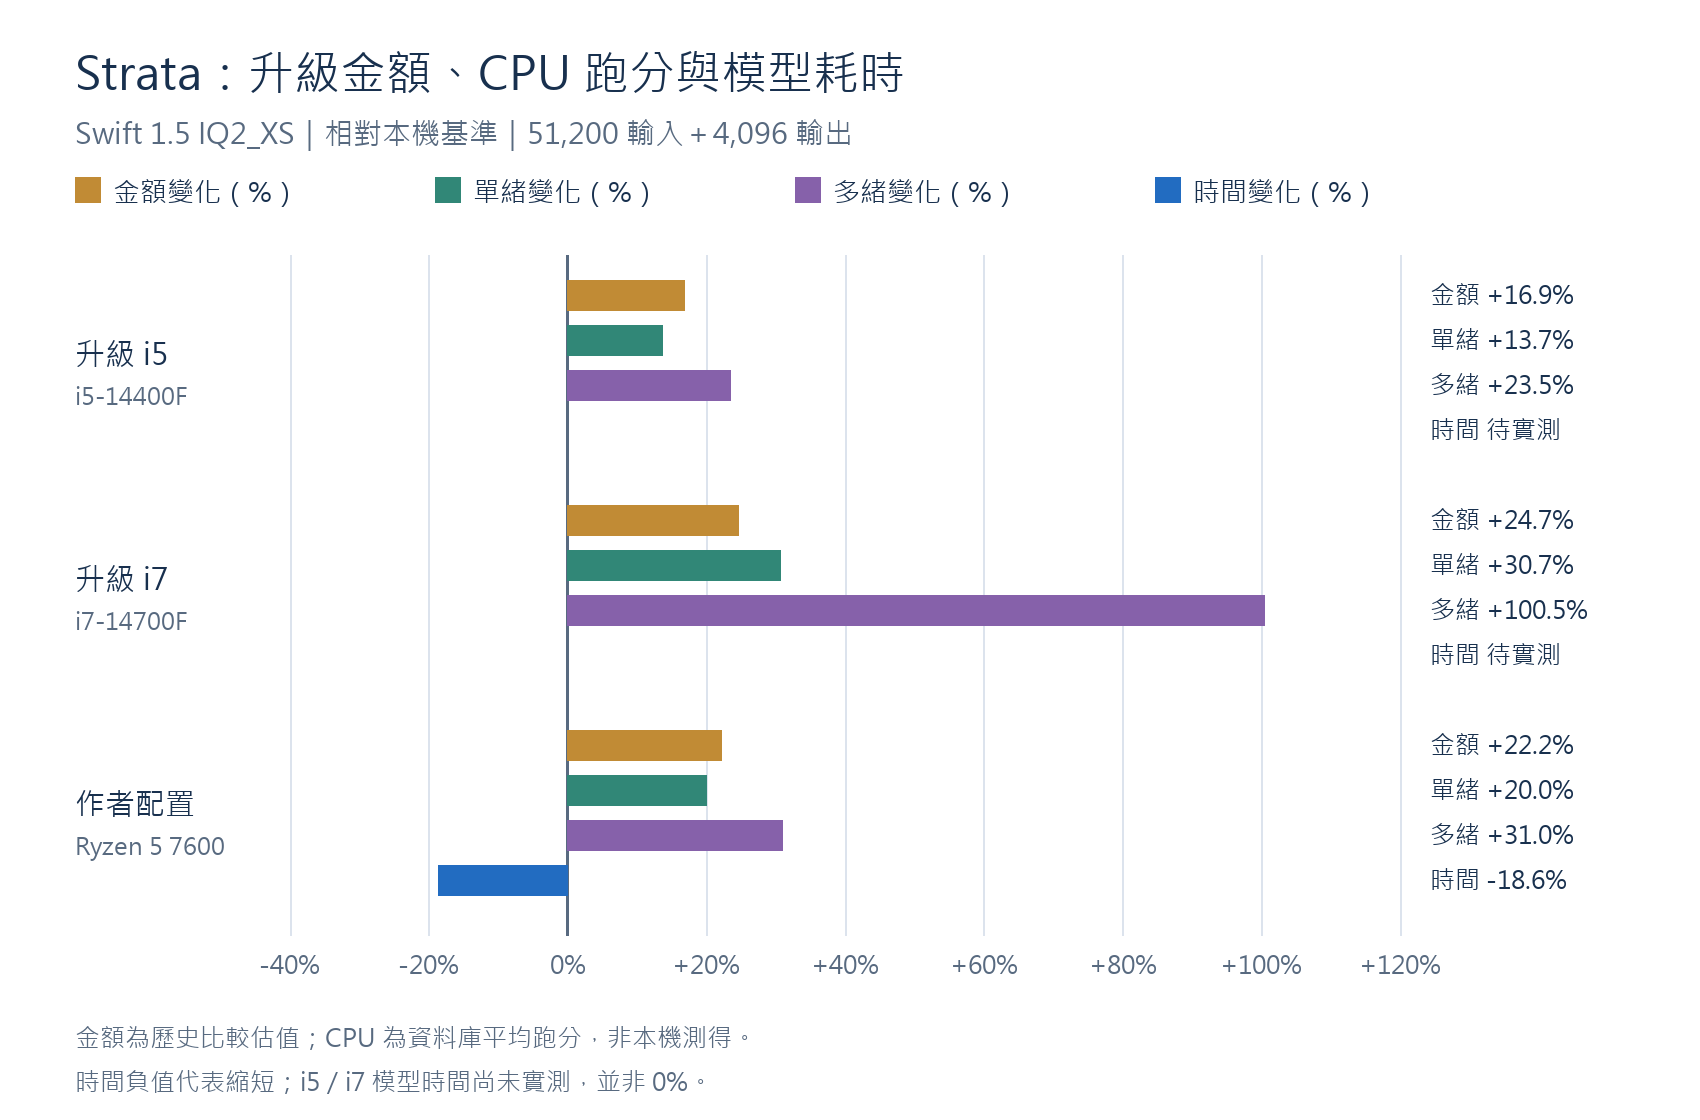
成本口徑:保留一顆 2TB M.2 SSD、不含 HDD。i5/i7 套餐歷史支出為 NT$11,790/NT$17,190,直接疊加在原配置全新重估 NT$69,656 上;未扣除舊 CPU、主機板的估值或轉售收入。作者 NT$85,118 是含替代零件的同級整機估值,不是實際購入價。因此四欄並非相同口徑的新購整機價格。
CPU 增幅來自 PassMark 資料庫樣本平均,並非四台電腦各自的實測,也不代表 Strata 同幅加速。作者的 DDR5-5200 通道配置未確認,83.2 GB/s 只是假設雙通道的理論值。雙方模型雖同標 Swift 1.5 IQ2_XS,引擎版本、MTP 詞彙表及提示文字仍不同,作者亦未記錄模型檔案 SHA。名義 32K/4K 檔位的實際 prompt 為 31,566/3,562 tokens。
早期原版 IQ2_XS 曾估 i5 約 2,000/73、i7 約 2,000/77 tokens/s(Prefill/Decode),這些歷史估算不適用於 Swift,因此沒有填入表格。
為何採 51,200 輸入+4,096 輸出?
TraceLab 公開研究的 23.4 億未命中快取輸入與 1.869 億輸出,整體比例約 12.52:1。此處取 12.5:1,沿用 4,096 輸出作比較尺度,得到 51,200 輸入。輸入排除命中快取部分、包含快取失效後重算;輸出包含思考、工具呼叫、程式碼和回答。
這是按整體比例標準化的情境,不是每輪或每個 coding-agent 任務的平均。研究使用 Claude/Codex,並非本機 Qwen;累計輸入亦不是單輪上下文長度。
合成耗時 T = 51,200 ÷ Prefill + 4,096 ÷ Decode
省時百分比 = (1 − T ÷ 基準耗時) × 100%
耗時變化率 = (T ÷ 基準耗時 − 1) × 100%
兩種百分比正負號相反:第一張表採「省時」,Swift 表與下方示例採「耗時變化」。計算使用未四捨五入的值,顯示秒數相加可能差 0.1 秒。
上述秒數沿用 32K Prefill、4K Decode 的固定速度,沒有逐輪配合上下文長度調整,也不包含工具執行、編譯、測試、網路、調度及額外摘要。因此它是模型固定工作量比較,不是完整 coding-agent 任務耗時。更精確的估算需逐輪、同上下文長度測速。
歷史頻寬示例:假設等待占比 24.1% 時會如何?
以下只示範 Amdahl 定律,不是 v4 預測,也不是升級實測。基準改回 Swift IQ2_XS 的 94.1 秒。
| 配置 | 等待占比假設 | 模型總耗時 | 減少秒數 | 耗時變化 |
|---|---|---|---|---|
| 目前:PCIe 4.0 ×8+DDR4-3200 雙通道 | 基準 | 94.1 秒 | — | — |
| PCIe 5.0 ×8+DDR4-3200 雙通道 | PCIe 等待 24.1% | 82.7 秒 | 11.3 秒 | −12.1% |
| PCIe 4.0 ×8+DDR5-5200 雙通道 | DDR 等待 24.1%(額外假設) | 85.3 秒 | 8.7 秒 | −9.3% |
| PCIe 4.0 ×8+DDR5-6000 雙通道 | DDR 等待 24.1%(額外假設) | 83.5 秒 | 10.6 秒 | −11.2% |
| PCIe 5.0 ×8+DDR5-5200 雙通道 | PCIe 與 DDR 各 24.1%,合計 48.2%(互不重疊假設) | 74.0 秒 | 20.1 秒 | −21.3% |
| PCIe 5.0 ×8+DDR5-6000 雙通道 | PCIe 與 DDR 各 24.1%,合計 48.2%(互不重疊假設) | 72.1 秒 | 21.9 秒 | −23.3% |
24.1% 來自 DALI 的 PCIe 傳輸占比。試算額外假設它都是可隨頻寬改善、且未被其他運算重疊的等待;DDR 使用同一比例沒有研究或本機測量支持。合併方案再假設兩者各占 24.1%、互不重疊,合計 48.2%;若實際重疊,會高估收益。
單項:T新 = T原 × (1 − 0.241 + 0.241 ÷ 頻寬倍率)
合併:T新 = T原 × (1 − 0.241 − 0.241 + 0.241 ÷ 2 + 0.241 ÷ DDR倍率)
PCIe、DDR5-5200、DDR5-6000 的倍率分別為 2、1.625、1.875,假設有效頻寬依理論值等比例增加;不包含 CPU 更換效應。各列獨立對照基準,不能把這組結果當成前表的額外加速量。
怎麼判斷升級是否划算?
先確認現有 RAM 是否不足,再以實際新增支出、使用頻率和節省時間評估。i5/i7 套餐尚缺 Swift 實測,無法僅憑 CPU 跑分判斷;單換 RTX 5070 的 v4 結果接近持平,也不足以構成升級理由。高階 GPU 的預估省時較大,但仍應把這些條件式結果當成測試方向,而非購買承諾。
資料來源
- Strata 作者的 0.1.26 速度測試、原始測速資料及技術說明。
- PassMark:i7-11700、i5-14400F、i7-14700F、Ryzen 5 7600。2026 年 10 月 11 日記錄的單/多執行緒分數依序為 3,255/20,583、3,700/25,413、4,254/41,262、3,907/26,959;與 v4 固定基準 20,585 分屬不同資料截點。
- 歷史套餐來源:PChome i5-14400F 套餐、i7-14700F 套餐。本文不宣稱目前仍有相同價格或庫存。


留言討論