64 GiB 記憶體搭配 RTX 5060 Ti 16GB,執行原版 Qwen3.8-Flash-Next IQ3_XXS 的最新實測中位數:Prefill 1,665.73、Decode 51.65 tokens/s。以下整理模型品質、記憶體用量,以及本機與 Strata 作者的速度比較。
Strata 系列:模型比較與實測 · 硬體公式與驗證 · 升級成本與效益
最新實測:Strata 0.1.43.1
2026 年 10 月 13 日,以 i7-11700、RTX 5060 Ti 16GB、64GB DDR4-3200 雙通道主機,沿用 0.1.41 的提示與設定,各測九次;下表單位均為 tokens/s。
| 測試 | 0.1.41 | 0.1.43.1 | 速度變化 | 新版最低~最高 |
|---|---|---|---|---|
| Prefill/名義 32K | 1,666.44 | 1,665.73 | −0.04% | 1,642.28~1,672.80 |
| Decode/名義 4K | 51.30 | 51.65 | +0.68% | 51.23~52.43 |
| 次數 | Prefill/名義 32K | Decode/名義 4K |
|---|---|---|
| 1 | 1,672.80 | 51.65 |
| 2 | 1,672.26 | 51.65 |
| 3 | 1,665.73 | 51.23 |
| 4 | 1,667.96 | 51.50 |
| 5 | 1,642.28 | 51.75 |
| 6 | 1,655.38 | 51.24 |
| 7 | 1,655.48 | 51.77 |
| 8 | 1,669.69 | 52.43 |
| 9 | 1,655.81 | 51.77 |
測試使用 65,536 上下文、INT8 KV、KV resident 32,768、顯存預留 1,500 MiB、專家快取與 Prefill auto、MTP spec 4/min-p 0.5、greedy。每次啟動全新引擎並輸出 256 tokens;停止 HTTP 與看圖服務,不重用提示快取,未清除作業系統檔案快取,計時不含模型載入。
名義 32K/4K 的實際提示為 31,566/3,562 tokens;Prefill 計時涵蓋 31,565/3,561 tokens,最後一個提示 token 留給首步 Decode。提示為保存的替代原始碼,並非作者未公開的原文。兩版中位數接近,但背景活動與溫度無法完全重建;以下跨主機比較及 v4 公式仍沿用 0.1.41 基準。
本機與作者的同模型比較
| 項目 | 本機 | Strata 作者 |
|---|---|---|
| CPU | Intel Core i7-11700 | AMD Ryzen 5 7600 |
| GPU | RTX 5060 Ti 16GB | RTX 5070 12GB |
| 顯卡連線 | PCIe 4.0 ×8 | PCIe 5.0 ×16 |
| RAM | 64GB DDR4-3200,雙通道 | 64GB DDR5-5200,通道未確認 |
IQ2_XS 雙方均使用 Swift 1.5;IQ3_XXS 雙方均使用原版 Qwen。本機為 2026 年 10 月 11 日各九次的中位數,作者每格為單次測量。下表秒數統一按 51,200 輸入+4,096 輸出 tokens換算。
| 模型/項目 | 本機速度 | 作者速度 | 作者速度提升 | 本機秒數 | 作者秒數 | 作者耗時減少 |
|---|---|---|---|---|---|---|
| Swift IQ2_XS/Prefill | 1,622.10 | 2,092.02 | +29.0% | 31.6 | 24.5 | 22.5% |
| Swift IQ2_XS/Decode | 65.55 | 78.60 | +19.9% | 62.5 | 52.1 | 16.6% |
| Swift IQ2_XS/合計 | — | — | — | 94.1 | 76.6 | 18.6% |
| 原版 IQ3_XXS/Prefill | 1,666.44 | 1,745.16 | +4.7% | 30.7 | 29.3 | 4.5% |
| 原版 IQ3_XXS/Decode | 51.30 | 61.64 | +20.2% | 79.8 | 66.5 | 16.8% |
| 原版 IQ3_XXS/合計 | — | — | — | 110.6 | 95.8 | 13.4% |
耗時減少=1−作者秒數÷本機秒數;速度提升=作者 tokens/s÷本機 tokens/s−1,均以未四捨五入數值計算。這是模型推論時間換算,不是完整 coding-agent 任務的實測耗時。
作者使用 Strata 0.1.26、英語 MTP 詞彙表;本機使用 0.1.41、CJK MTP 詞彙表,提示及上下文/KV 條件也不完全相同,因此不能把差距全歸因於硬體。本機原版 IQ3_XXS 比 Swift IQ2_XS 的 Prefill 快 2.7%、Decode 慢 21.7%,同時涉及模型變種與量化差異。
ISTA 量化品質:LiveCodeBench v6
以下為 ISTA-DASLab 的原版量化評測,不包含 Swift 1.5。分數越高越好;下載大小使用十進位 GB,不等於執行時 RAM 用量。
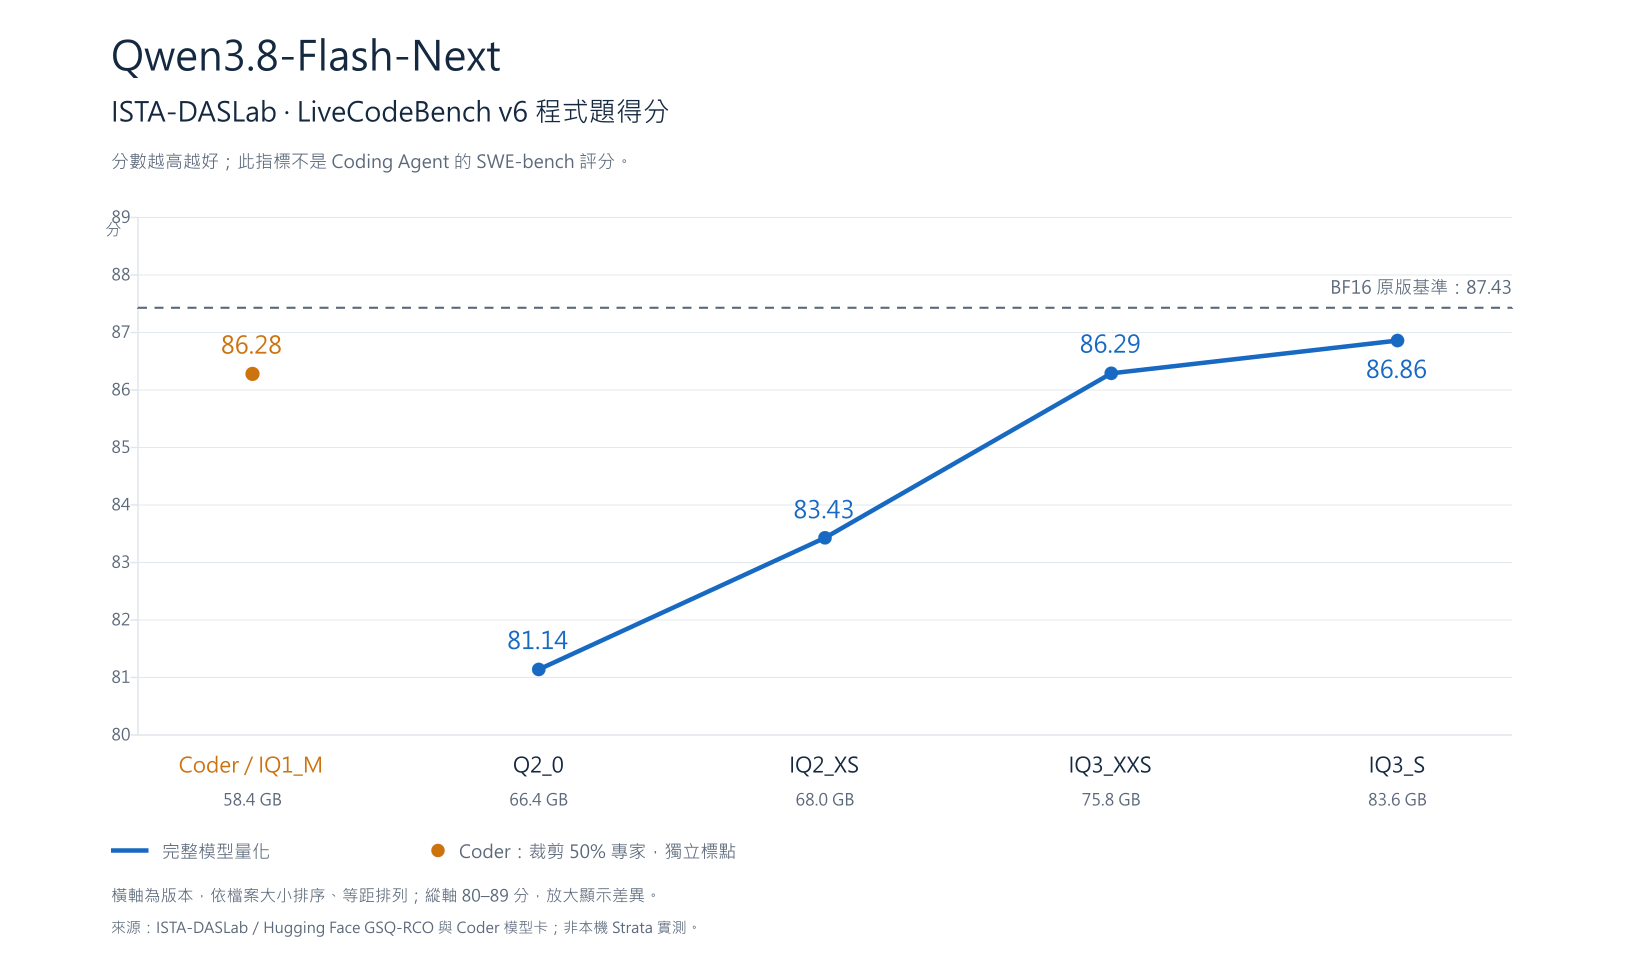
| 版本 | 下載大小(GB) | LiveCodeBench v6 |
|---|---|---|
| Q2_0 | 66.4 | 81.14 |
| IQ2_XS | 68.0 | 83.43 |
| IQ3_XXS | 75.8 | 86.29 |
| IQ3_S | 83.6 | 86.86 |
| Coder IQ1_M,裁剪 50% 專家 | 58.4 | 86.28 |
| BF16 原版基準 | — | 87.43 |
IQ3_XXS 到 IQ3_S 增加 7.8 GB 下載量,得分提高 0.57 分。Coder 是獨立的專家裁剪版本,不能視為單純降低量化精度。圖表縱軸從 80 分起以放大差異;程式題分數不代表完整 coding-agent 任務成功率。來源:ISTA 原版量化評測、Coder 模型卡。
64 GiB RAM 還剩多少?
2026 年 10 月 13 日,IQ3_XXS、65,536 上下文、啟用看圖;本節容量統一為 GiB。
| 項目 | GiB |
|---|---|
| 安裝總容量 | 64.00 |
| Windows 可使用總容量 | 63.84 |
| 官方 RAM 概估 | 45.63 |
| 扣除官方概估後剩餘 | 18.20 |
| 本機卸載/重載實測增量,含看圖 | 44.12 |
| 扣除實測增量後剩餘 | 19.72 |
剩餘容量仍包含 Windows 與其他程式已使用的部分,不是當下空閒 RAM。44.12 GiB 是整機卸載/重載前後差值,受快取與背景活動影響,不是程序獨占用量;官方與實測兩列分別計算,不重複扣除。差額以未四捨五入數值計算。官方依據:Strata 模型記憶體概估。
測速來源
- 作者 Strata 0.1.26 測速說明與逐次原始數據。
- Strata 技術說明。
- 本機 Swift 使用固定版本模型檔;作者資料未提供檔案 SHA,無法確認逐位元相同。
- 本機九次原始輸出、提示、設定與 RAM 量測紀錄由測試者保存;本文列出彙總及新版逐次結果。


留言討論